AI自动菌落计数分割模型助力拆分粘连菌落
2026-11-13 来源:本站 点击次数:32菌落世界篇
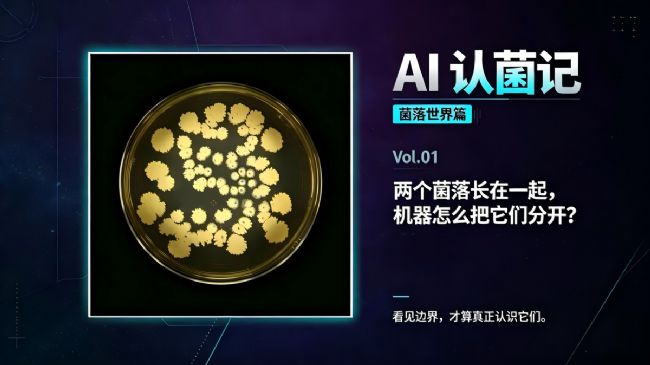
高峰期的微生物实验室,培养箱一开门,几十个平皿等你数。 大部分平皿都好办。直到你翻开这一个—— 菌落不是一颗一颗的,而是长成了一团。三五个、十几个菌落挤在一起,边缘互相吃进对方的领地,肉眼只能估算:"大概……十几二十个?"
这就是菌落计数里最经典的问题:粘连菌落(overlapping colonies)。
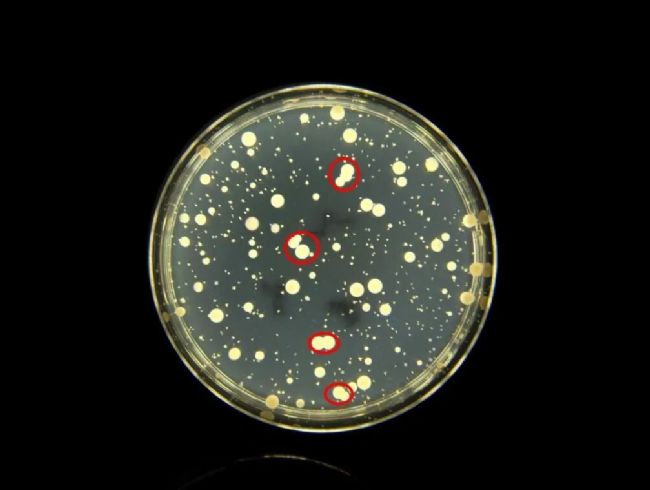
对一台计数仪来说,真正的难点是图像分割:先精确划出哪个像素属于菌落 A、哪个属于菌落 B,然后才是数。
如果分割做不好,会出现两类经典错误:
粘连误判:5 个长在一起的菌落被当成 1 个 → 结果偏低
杂质误判:气泡、划痕、杂质被当成菌落 → 结果偏高。
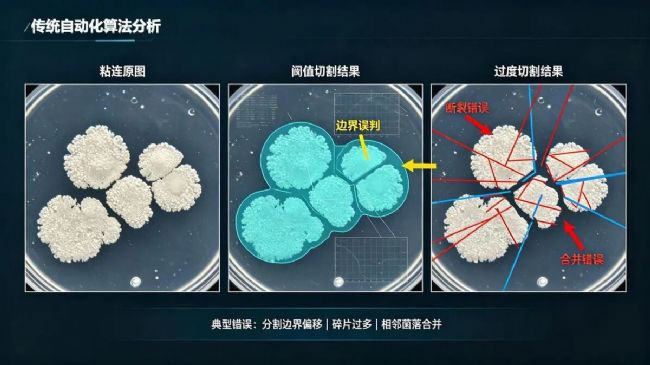
自动菌落计数不是新概念,老式设备十多年前就有,但普遍卡在三件事上:
① 阈值切割的硬伤:靠一条固定灰度线区分菌落和培养基,光照一偏、颜色一浅就失灵;粘连菌落在阈值图里是一整块连通区域,数出来永远是 1。
② 分水岭算法的过度切割:能把连通块切开,却常把边缘毛糙的单个菌落切成两三块——粘连的没分开,单独的被切碎。
③ 光学信息的浪费:普通工业相机+固定光源,边缘糊成一团,算法再好也是盲人摸象。
1.光学层:为菌落定制成像。
光路和成像组件全部自研,光照角度、色温、分辨率按菌落形态学特点设计——边缘信息保得越完整,算法余地就越大。光学和算法是耦合的,买来拼装做不到两头最优。
2.识别层:深度学习分割模型。
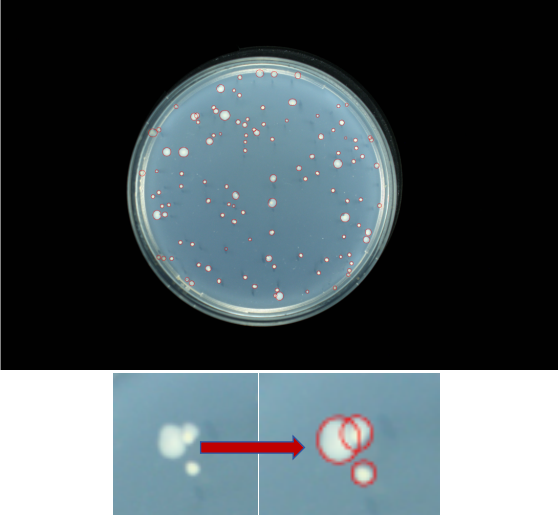
神经网络做像素级分割,学的不是“颜色深=菌落”,而是形态语义:圆形轮廓、边缘特征、生长纹理。粘连菌落间的“细腰”能被识别、沿凹陷切开;气泡、划痕因形态不符被排除,不误判为菌落。
3.校验层:与人工金标准对齐。
模型上线前,用大量人工标注的平皿图像验证,粘连场景的计数结果与有经验检测员的判定对齐;每次模型升级都重新过验证,确保结果不倒退。
自 2017 年首款全自动菌落分析仪起,泽析的产品全栈自研——这是“整条链路自己调”的底气。
一、准:机器不累,标准不漂
人工数菌落,误差来自人和人的差异:连续看几十块平皿会疲劳,不同检测员判定不一。机器没有这个问题——同一张图重复检测,结果是同一个数。
粘连、连片样品是准确率的分水岭:分割模型按形态语义识别,粘连处的凹陷边界能被识别并沿凹陷切开。
单平皿 2 秒左右出结果——快不是噱头,快意味着可以做平行样、可以复检,质控才有余地。
二、可溯源:每一个数都能翻回原图
泽析输出的每一个结果都能翻回原始图像:每颗菌落的分割边界、计数依据全部留存,原始图片与结果绑定归档。
软件具备三级用户管理权限、全流程操作留痕与完整审计轨迹,并同步输出原始图像与数值——软件系统部分兼容 21 CFR Part 11 规范要求。
三、可控:参数跟着你的实验流程走,而不是反过来
硬件光路、成像、算法全部自研,有 6 项软件著作权与 2 项发明专利支撑;统计口径、报告模板可按实验室流程定制——自研团队可以直接改。
一句话:准,是算得对;可溯源,是说得清;可控,是改得动。